Et af mine to overordnede læringsmål på 4. semester handler om backendudvikling. Mit mål er ikke kun at kunne programmere en backend, men at kunne designe og implementere den på en struktureret måde og samtidig kunne begrunde mine valg omkring API-design, arkitektur, forretningslogik og ansvarsfordeling.
I semesterprojektet QuestGame arbejder jeg med en backend i C# med ASP.NET Core. Backendens opgave er blandt andet at håndtere spil, aktiviteter, deltagere, besvarelser og point samt kommunikere med en PostgreSQL-database gennem Entity Framework Core.
Projektet har allerede givet mig anledning til flere overvejelser, som har ændret mit syn på backendudvikling. Hvor jeg tidligere primært har betragtet en backend som noget, der modtager en HTTP-request, henter eller gemmer noget data og sender et svar tilbage, er jeg i højere grad begyndt at se backendens struktur som en del af selve problemløsningen. Det er også i høj grad backendens design, der enten begrænser eller udvider mulighederne for det fulde system. Derfor er opgaven som backendudvikler i høj grad at lytte til og forstå kravspecifikationer, forretningsdomæner, være proaktiv og kunne forudse eventuelle udfordringer/flaskehalse i systemet.
Indlægget herunder er delvist sammenfattet med hjælp fra AI og samler mine indledende overvejelser, dokumenterer min læring og gennemgår hvad jeg har fundet ud af indtil nu.
Fremadrettet vil jeg udgive kortere indlæg og opdateringer med ting, jeg har opdaget og ting, jeg har lært.
Fra endpoints til ansvar
Et API-endpoint kan i sig selv være forholdsvis simpelt.
Et endpoint til at indsende en aktivitet kunne eksempelvis ende med at ligne noget i denne retning:
[HttpPost]
public async Task<IActionResult> Submit(
    CreateSubmissionRequest request)
{
    await submissionService.SubmitAsync(request);

    return Ok();
}Code language: C# (cs)
Det interessante spørgsmål er derfor ikke nødvendigvis, hvordan jeg laver selve endpointet. Det interessante er snarere:
Hvad skal der ske mellem requesten kommer ind, og svaret bliver sendt tilbage? Og hvor skal de forskellige ting ske?
Requesten skal måske valideres. Det skal kontrolleres, om spilleren faktisk deltager i spillet. Aktiviteten skal eksistere. Spilleren må måske kun aflevere én gang. Besvarelsen skal gemmes, og afhængigt af aktivitetstypen skal den enten evalueres automatisk eller senere gennemgås af en lærer.
Hvis al den logik placeres direkte i controlleren, kan endpointet hurtigt blive svært at læse og vedligeholde.
Det har fået mig til at arbejde mere bevidst med ansvarsfordeling. Controllerens primære ansvar bør efter min opfattelse være HTTP-delen af systemet, mens selve use casen håndteres længere inde i applikationen.
Det hænger direkte sammen med mit læringsmål om at kunne træffe og begrunde valg omkring backendens struktur og ansvarsfordeling. Jeg kan godt få et endpoint til at virke uden at tænke særligt meget over arkitektur. Udfordringen er at skabe en struktur, som stadig giver mening, når systemet bliver større.
Hvor meget arkitektur har vi egentlig brug for?
En af mine tidlige overvejelser har været, hvordan backendprojektet skulle struktureres.
Jeg har tidligere arbejdet med blandt andet Clean Architecture, hvor systemet opdeles i flere lag med tydelige afhængighedsregler. Det har flere fordele, men QuestGame har samtidig fået mit til at tænke over, at “mere” arkitektur ikke nødvendigvis betyder bedre arkitektur.
Projektet skal udvikles inden for ét semester og har et relativt afgrænset domæne. Hvis vi introducerer mange projekter, interfaces og abstraktioner fra starten, risikerer vi at bruge meget tid på struktur, som ikke giver en tilsvarende gevinst.
Vores foreløbige tilgang er derfor at holde backend relativt enkel og i højere grad strukturere funktionaliteten omkring systemets features og use cases.
Det kunne eksempelvis være områder som:
- Games
- Activities
- Participants
- Submissions
- Scoring
I stedet for udelukkende at tænke:
- Controllers
- Services
- Repositories
- Models
Den første struktur fortæller i højere grad, hvad systemet kan, mens den anden primært fortæller, hvilken teknisk rolle filerne har.
Det betyder ikke, at lagdeling eller Clean Architecture er forkert. Tværtimod kan principper derfra stadig være relevante. Min læring består i højere grad i at kunne vurdere, hvilke principper der faktisk løser et problem i vores projekt, frem for at anvende en bestemt arkitektur, fordi den betragtes som mere avanceret.
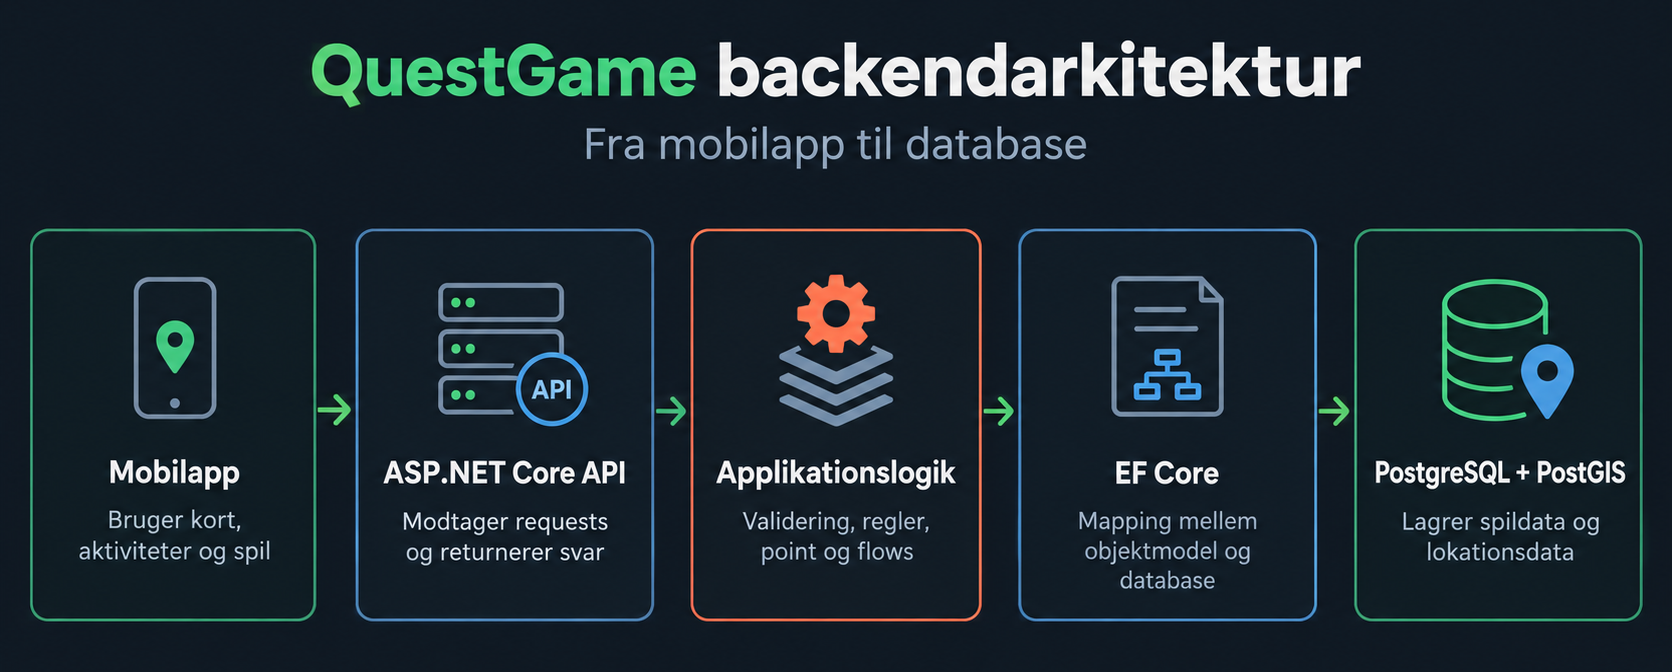
Dette er et godt eksempel på koblingen til mit læringsmål. Målet siger, at jeg skal kunne begrunde arkitekturvalg. Derfor er det ikke nok, at jeg kan fortælle, hvilken arkitektur vi bruger. Jeg skal også kunne forklare, hvorfor den passer til projektets størrelse og behov.
Forretningslogik: Hvornår er en aktivitet egentlig gennemført?
En af de mere interessante problemstillinger er opstået omkring deltagernes besvarelser.
QuestGame kan indeholde forskellige typer aktiviteter. Eksempelvis kan en deltager:
- besvare en quiz
- løse en opgave og indsende et resultat
- gennemføre en fysisk aktivitet
Ved første øjekast kunne alle tre behandles som en almindelig Submission. Men deres adfærd er forskellig.
En quiz kan i mange tilfælde kontrolleres automatisk. Systemet kender det korrekte svar og kan derfor straks afgøre, om besvarelsen er godkendt.
En almindelig opgave eller fysisk aktivitet kan derimod kræve, at en lærer eller game master efterfølgende vurderer besvarelsen.
Vi er derfor kommet frem til et flow, hvor eksempelvis TaskSubmission og ActivitySubmission kræver manuel godkendelse, mens en QuizSubmission kan evalueres automatisk.
Ved manuel evaluering ønsker vi samtidig at holde modellen simpel: en besvarelse bliver enten Approved eller Rejected. Der skal ikke gives 70 %, tre ud af fem stjerner eller lignende.
Det er et forholdsvis lille designvalg, men det påvirker store dele af backendens adfærd.
En forenklet status kunne eksempelvis være:
public enum SubmissionStatus
{
    Pending,
    Approved,
    Rejected
}Code language: C# (cs)
Det rejser efterfølgende spørgsmål som:
Hvornår må point tildeles? Må en besvarelse godkendes to gange? Hvem må ændre status? Hvad sker der, hvis aktiviteten senere ændres?
Det er netop her, jeg oplever forskellen mellem CRUD og egentlig backendudvikling.
CRUD kan fortælle mig, hvordan jeg gemmer en Submission. Forretningslogikken fortæller mig, hvornår en Submission må oprettes, ændres og føre til andre ændringer i systemet.
Det understøtter direkte den del af mit læringsmål, der handler om at kunne håndtere forretningslogik og ansvar mellem backendens komponenter.
Point skal ikke bare kunne beregnes
Pointsystemet har givet anledning til en anden interessant beslutning.
En simpel tilgang kunne være aldrig at gemme de point, en spiller har fået. I stedet kunne backend beregne dem ud fra de gennemførte aktiviteter, hver gang der er behov for spillerens score.
Det virker umiddelbart attraktivt, fordi man undgår at gemme information, som i princippet kan beregnes.
Problemet opstår, hvis en aktivitets pointværdi senere ændres.
Forestil dig følgende:
- Mandag:
- Aktivitet A giver 10 point.
- Jeg gennemfører aktiviteten.
- Fredag:
- Læreren ændrer Aktivitet A til 20 point.
Hvis min score altid beregnes ud fra aktivitetens nuværende værdi, vil min historiske score pludselig stige fra 10 til 20 point.
Men jeg fik jo 10 point, da aktiviteten blev gennemført.
Derfor giver det bedre mening at gemme de faktisk tildelte point, eksempelvis som:
public int? PointsAwarded { get; set; }Code language: C# (cs)Pointene tildeles først, når en submission er blevet godkendt eller en quiz automatisk er blevet evalueret.
Dermed bliver PointsAwarded ikke bare en kopi af aktivitetens nuværende pointværdi. Feltet bliver en del af systemets historik.
Denne overvejelse ligger faktisk i spændingsfeltet mellem mine to læringsmål. Det er en backendregel, men den påvirker samtidig datamodellen. Det er også en del af årsagen til, at jeg har valgt både backendudvikling og databaser som emner på 4. semester: beslutninger i det ene område påvirker næsten altid det andet.
EF Core er mere end en genvej til SQL
Til kommunikationen med PostgreSQL bruger projektet Entity Framework Core.
En af fordelene ved EF Core er, at jeg kan arbejde med C#-objekter og LINQ frem for selv at skrive SQL til alle operationer.
Eksempelvis:
var game = await dbContext.Games
    .Include(g => g.Activities)
    .FirstAsync(g => g.Id == gameId);Code language: C# (cs)
Det kan gøre dataadgangen meget naturlig fra backendens perspektiv.
Men arbejdet med EF Core har samtidig gjort det tydeligt for mig, at objektmodellen og den relationelle datamodel ikke er det samme.
I C# kan jeg eksempelvis have:
game.ActivitiesCode language: C# (cs)mens relationen i databasen i sidste ende repræsenteres gennem primær- og fremmednøgler.
EF Core står dermed som et lag mellem to forskellige måder at modellere data på.
Det betyder også, at jeg ikke blot kan designe mine C#-klasser uden at tænke over, hvordan de ender i databasen. Relationer, nullability, foreign keys, constraints og indlæsning af relaterede objekter påvirker både backend og database.
Det er endnu et punkt, hvor mit læringsmål om backendens dataadgang og ansvarsfordeling overlapper naturligt med mit læringsmål om databaser.
Code First og migrations
Vi arbejder med EF Core efter en Code First-tilgang.
Det betyder i praksis, at vores model defineres i backendprojektet, hvorefter EF Core kan generere migrations, der beskriver de nødvendige ændringer i PostgreSQL.
Et typisk workflow kan eksempelvis være:
dotnet ef migrations add AddSubmissions
dotnet ef database updateCode language: Bash (bash)
Jeg opfattede tidligere migrations mest som en praktisk måde at få EF Core til automatisk at ændre databasen.
Jeg ser dem nu i højere grad som versionsstyring af databasens struktur.
Når datamodellen ændrer sig, bliver ændringen eksplicit repræsenteret i projektet. Det gør det muligt at følge udviklingen fra eksempelvis en tidlig model med Game og Activity til en mere komplet model med deltagere, submissions, godkendelsesstatus og point.
Det betyder dog ikke, at en autogenereret migration nødvendigvis er korrekt, bare fordi EF Core kan generere den. Jeg skal stadig forstå, hvad migrationen ændrer, og hvilke konsekvenser ændringen har for eksisterende data.
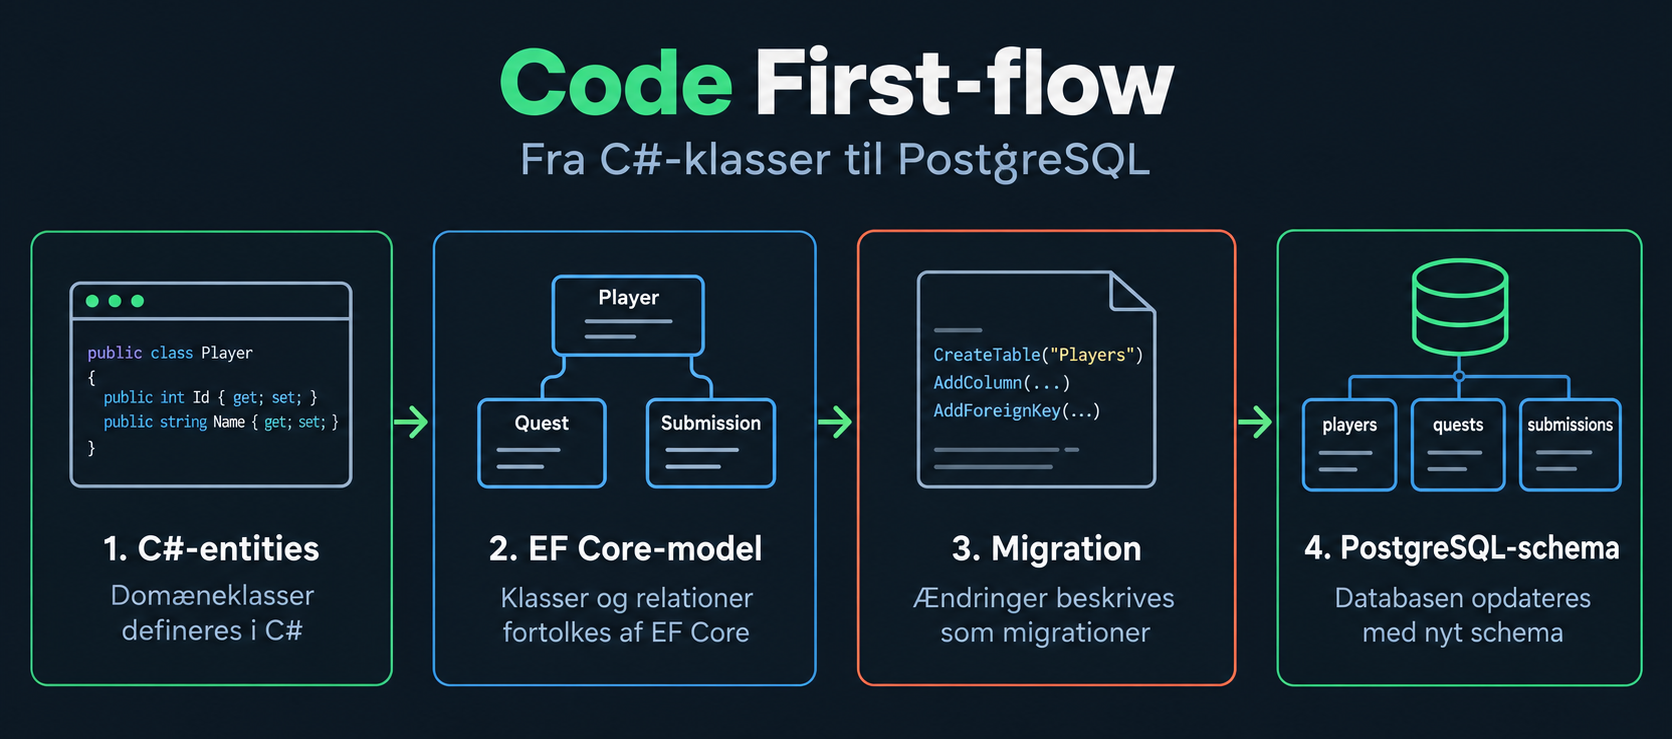
Også her er der en forbindelse til læringsmålene. Jeg bruger teknologien i praksis, men målet er samtidig at kunne forklare hvad EF Core gør for mig, og hvilke beslutninger jeg stadig selv er ansvarlig for.
PostGIS flytter noget af arbejdet tættere på databasen
QuestGame adskiller sig fra mange af mine tidligere projekter ved, at geografisk placering er en central del af domænet.
Et waypoint er ikke bare et navn og et koordinatpar. Backend skal eksempelvis kunne afgøre, om en spiller befinder sig tilstrækkeligt tæt på et waypoint til at kunne interagere med det.
Til dette bruger vi PostgreSQL sammen med PostGIS.
På .NET-siden kan en geografisk position blandt andet repræsenteres gennem Point fra NetTopologySuite:
public Point Location { get; set; }Code language: C# (cs)Med Npgsql og NetTopologySuite kan sådanne typer mappes til spatiale typer i PostGIS.
Det interessante for mig er dog ikke kun, at PostgreSQL kan gemme koordinater.
Et vigtigere spørgsmål er:
Hvor skal afstandsberegningen foretages?
En mulighed ville være at hente alle waypoints fra databasen og derefter beregne afstandene i C#.
Det ville måske fungere fint med meget få waypoints, men det betyder samtidig, at backend henter data, som den efterfølgende sorterer fra igen.
En anden mulighed er at formulere forespørgslen, så beregningen udføres i databasen.
Et forenklet LINQ-eksempel kunne være:
var nearbyWaypoints = await dbContext.Waypoints
    .Where(w => w.Location.Distance(playerLocation) < radius)
    .ToListAsync();Code language: C# (cs)
Når operationen understøttes af provideren, kan den oversættes til en spatial forespørgsel i PostGIS.
Det giver databasen mulighed for kun at returnere de relevante resultater og samtidig udnytte funktionalitet og eventuelle spatiale indekser, som er udviklet specifikt til den type forespørgsler.
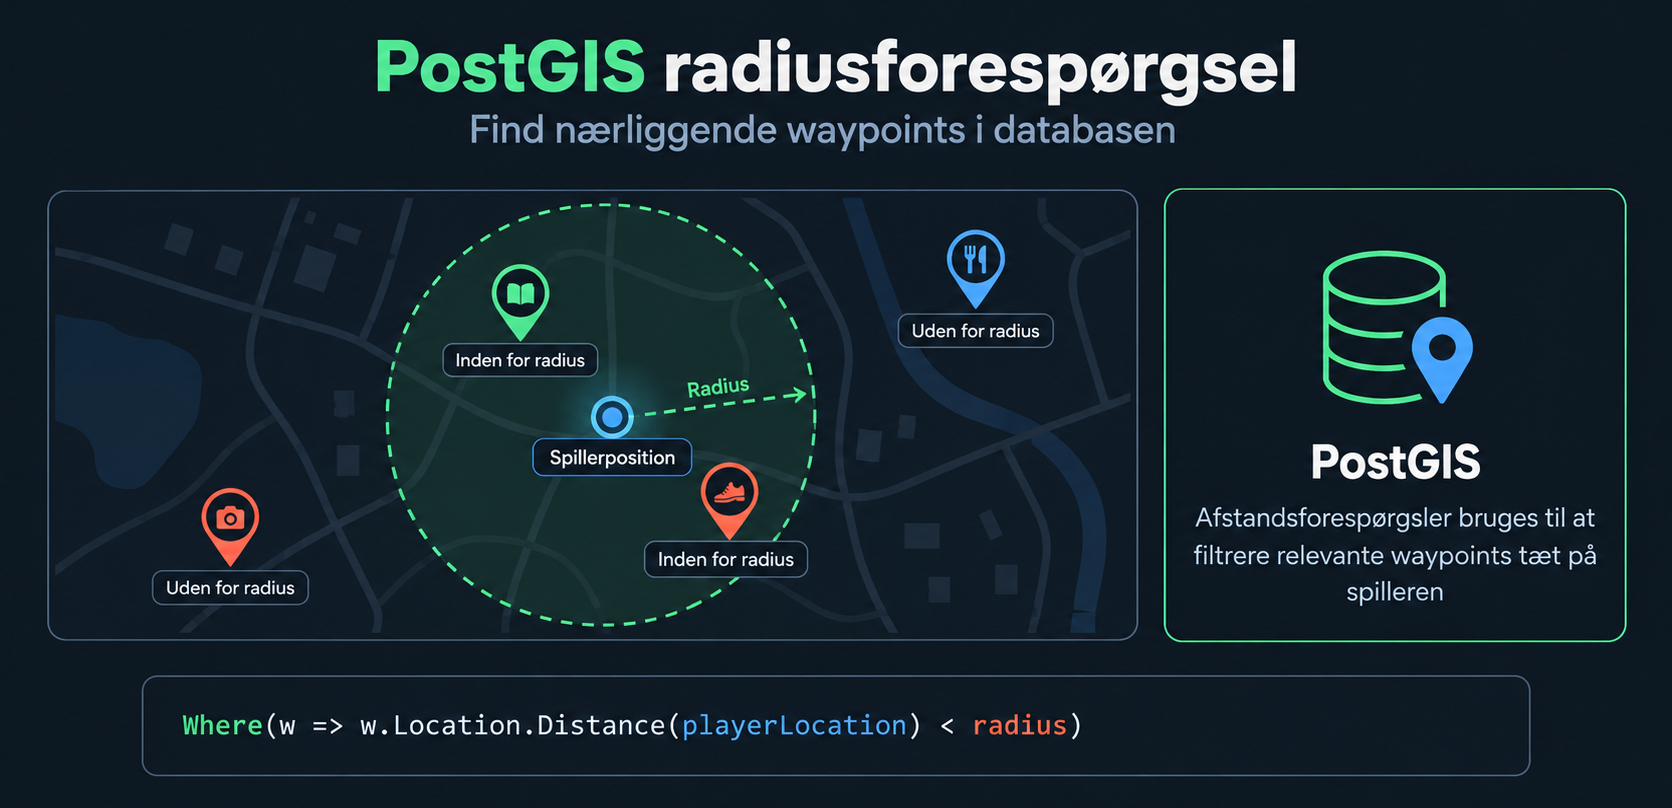
Denne problemstilling er et meget konkret eksempel på det, jeg ønskede at lære på semesteret: Jeg vil ikke bare vide, hvordan jeg laver en databaseforespørgsel. Jeg vil også kunne vurdere, om en opgave bør løses i backend eller database.
Jeg er blevet mere skeptisk over for unødvendige abstraktioner
En anden ting, jeg har lært indtil videre, er, at abstraktion ikke automatisk er en forbedring.
Et eksempel er repository-patternet.
Det kunne være fristende at oprette interfaces som:
- IGameRepository
- IActivityRepository
- ISubmissionRepository
- IPlayerRepository
og derefter implementere dem alle oven på EF Core.
Det kan være en god løsning i nogle systemer, men EF Core og DbContext tilbyder allerede en relativt omfattende abstraktion over dataadgangen.
Hvis mine repositories primært kommer til at indeholde metoder som:
GetByIdAsync()
AddAsync()
DeleteAsync()Code language: C# (cs)
skal jeg derfor overveje, om jeg faktisk har skabt en nyttig abstraktion, eller blot endnu et lag kode.
Der kan sagtens opstå situationer, hvor et repository giver mening. Men jeg forsøger i højere grad at lade et konkret problem være årsagen til, at jeg introducerer en abstraktion.
Det er en ændring i min måde at tænke systemudvikling på.
Tidligere kunne jeg være tilbøjelig til at spørge:
“Hvilket pattern bør jeg bruge?”
Jeg prøver i stedet først at spørge:
“Hvilket problem prøver jeg at løse?”
Hvis et pattern derefter hjælper med det problem, har jeg et bedre argument for at bruge det.
Det passer meget direkte til formuleringen i mit læringsmål om, at jeg skal kunne træffe og begrunde tekniske valg.
Status på mit læringsmål
Jeg er stadig undervejs med backenddelen af QuestGame, men projektet har allerede flyttet mit fokus fra selve kodningen til beslutningerne omkring koden.
Mit læringsmål er:
Jeg vil kunne designe og implementere en struktureret backend i ASP.NET Core, så jeg kan træffe og begrunde valg omkring API-design, arkitektur, forretningslogik og ansvarsfordeling mellem backendens forskellige komponenter.
Jeg synes især, at jeg indtil videre har arbejdet med tre dele af dette mål.
For det første er jeg blevet mere bevidst om arkitektur og struktur. Jeg forsøger at finde en balance, hvor systemet har tydelige ansvarsområder uden at blive unødvendigt kompliceret.
For det andet er jeg begyndt at betragte forretningslogikken som en central del af backenddesignet. Submission-flowet og pointtildelingen er gode eksempler på, at det ikke er nok at kunne oprette, læse, ændre og slette data.
For det tredje har arbejdet med EF Core, PostgreSQL og PostGIS givet mig en bedre forståelse af grænsen mellem backend og database. En vigtig del af dataadgang er ikke kun at kunne hente data, men også at overveje, hvor behandlingen af dem mest hensigtsmæssigt bør foregå.
Næste skridt bliver at få flere af disse beslutninger afprøvet gennem den faktiske implementering. Det bliver samtidig interessant at se, om den struktur, der virker fornuftig nu, fortsat gør det, efterhånden som flere features bliver implementeret.
Hvis ikke, er en ændring af arkitekturen ikke nødvendigvis et tegn på, at det første valg var forkert. Det kan lige så godt være en del af læringen: at opdage et nyt behov, ændre løsningen og bagefter kunne forklare hvorfor.
Det er i sidste ende også det vigtigste i mit læringsmål. Jeg skal ikke finde den ene “korrekte” måde at bygge en backend på. Jeg skal blive bedre til at forstå de valg, jeg foretager, og de konsekvenser de har.
 Client vs. Server Evaluation – EF Corelearn.microsoft.com (åbner i en ny fane)Migrations Overview – EF Corelearn.microsoft.com (åbner i en ny fane)Introduction to relationships – EF Corelearn.microsoft.com (åbner i en ny fane)
 Create web APIs with ASP.NET Corelearn.microsoft.com (åbner i en ny fane)