Mit andet overordnede læringsmål på 4. semester handler om databaser og datalagring. Her er mit mål ikke kun at kunne oprette tabeller og gemme data, men at blive bedre til at designe en relationel dataløsning og begrunde de valg, der ligger bag.
Indlægget herunder er delvist sammenfattet med hjælp fra AI og samler mine indledende overvejelser, dokumenterer min læring og gennemgår hvad jeg har fundet ud af indtil nu. Fremadrettet vil jeg udgive kortere indlæg og opdateringer med ting, jeg har opdaget og ting, jeg har lært.
I semesterprojektet QuestGame har jeg valgt at arbejde med PostgreSQL som relationelt databasesystem. Databasen integreres med backend gennem Entity Framework Core, og fordi geografiske lokationer er en central del af spillet, anvender vi desuden PostGIS.
Mit læringsmål handler derfor både om traditionel relationel datamodellering og om samspillet mellem databasen og backend:
Jeg vil kunne analysere projektets behov for datalagring og på den baggrund vælge og begrunde en egnet databaseløsning. Herefter vil jeg kunne designe og implementere løsningen og integrere den med backend gennem EF Core.
Undervejs i projektet er jeg blevet mere opmærksom på, at en database ikke bare er det sted, hvor backend gemmer sine objekter. Datamodellen er i sig selv en vigtig del af systemets design.
Datamodellen skal tage udgangspunkt i systemets behov
En af de første opgaver har været at omsætte spillets koncept til en egentlig datamodel.
QuestGame indeholder blandt andet:
- spil
- deltagere
- aktiviteter
- waypoints
- besvarelser
- godkendelser
- point
Det er forholdsvis nemt at lave en tabel for hvert begreb. Den sværere del er at beslutte, hvordan begreberne hænger sammen, og hvilke regler databasen skal understøtte.
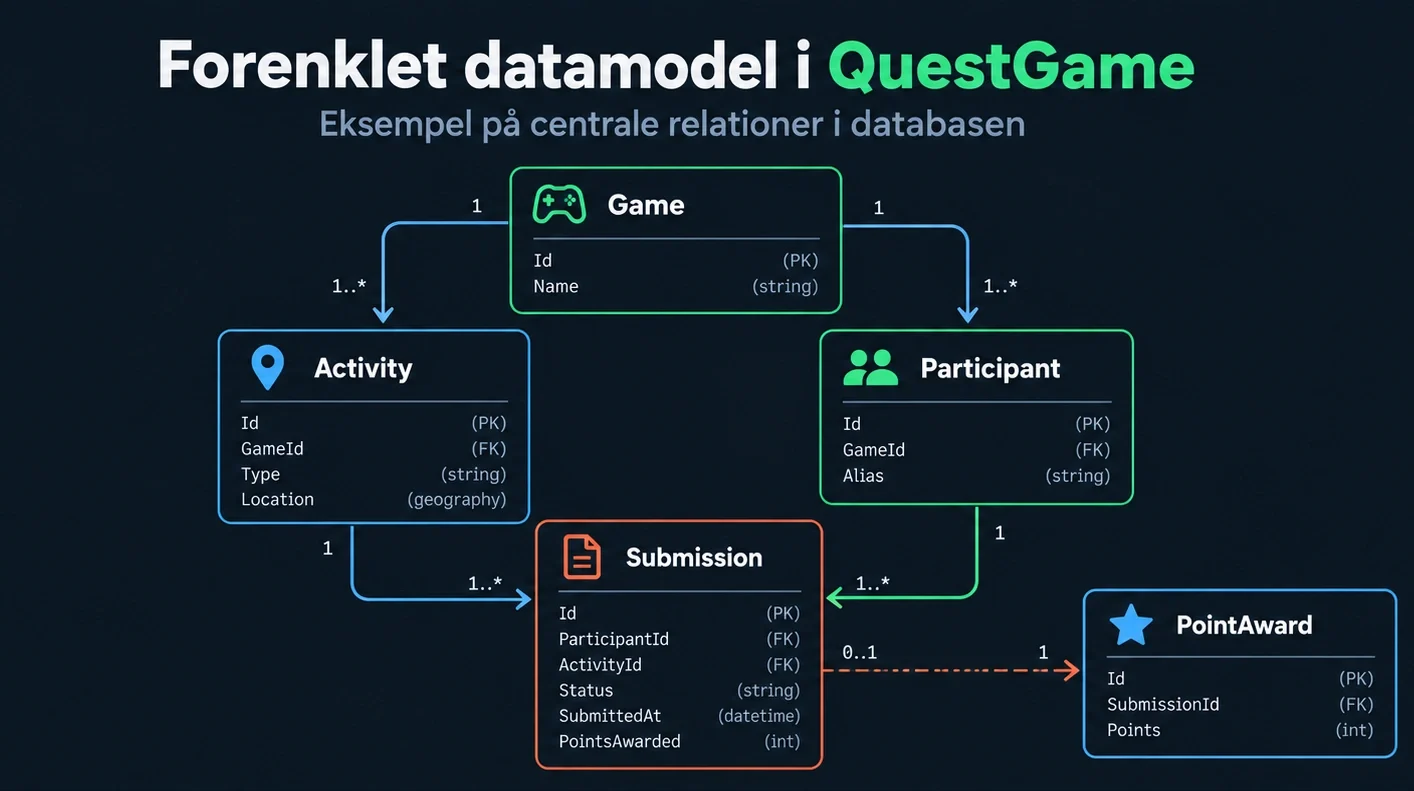
Et spil kan eksempelvis indeholde flere aktiviteter, mens en aktivitet tilhører et bestemt spil. Det kan beskrives som en klassisk en-til-mange-relation:
public class Game
{
    public int Id { get; set; }

    public ICollection<Activity> Activities { get; set; } = [];
}Code language: JavaScript (javascript)
og:
public class Activity
{
    public int Id { get; set; }

    public int GameId { get; set; }
    public Game Game { get; set; } = null!;
}Code language: JavaScript (javascript)
I backend fremstår relationen som objekter og properties. I PostgreSQL bliver den i stedet repræsenteret gennem primær- og fremmednøgler.
Det lyder måske som en lille forskel, men arbejdet med projektet har gjort det tydeligere for mig, at objektmodellen og databasemodellen ikke nødvendigvis bør betragtes som det samme.
Det hænger også sammen med mit læringsmål. Jeg skal ikke bare kunne oprette relationen med EF Core. Jeg skal også kunne forklare, hvorfor relationen ser ud, som den gør, og hvilke konsekvenser den har for resten af systemet.
Relationer fortæller noget om domænet
Relationer handler ikke kun om foreign keys.
De udtrykker også regler om systemet.
Hvis en Submission eksempelvis skal være knyttet til både en deltager og en aktivitet, fortæller datamodellen noget om, hvad en besvarelse er:
Participant <── Submission ──> ActivityCode language: HTML, XML (xml)En submission giver kun mening i relation til den deltager, der har afleveret den, og den aktivitet, der er blevet gennemført.
Det rejser samtidig nye spørgsmål.
- Kan samme deltager indsende flere besvarelser til den samme aktivitet?
- Kan en submission eksistere, hvis aktiviteten bliver slettet?
- Skal en deltager kunne fjernes, når vedkommende allerede har fået point?
Det er spørgsmål, som både påvirker backendens forretningslogik og databasens constraints.
Det er netop denne sammenhæng mellem backend og database, der var en af grundene til, at jeg valgte de to emner sammen.
Dataintegritet skal ikke kun afhænge af backend
Backend kan kontrollere mange af systemets regler.
Det kunne eksempelvis være:
if (submission.ActivityId <= 0)
{
    return BadRequest();
}Code language: JavaScript (javascript)
Men databasen har også mulighed for selv at beskytte sine data.
Hvis en Submission skal referere til en eksisterende Activity, kan en foreign key sikre, at databasen ikke accepterer en reference til en aktivitet, der ikke findes.
Det har fået mig til at tænke mere over forskellen mellem forretningsregler og dataintegritet.
En regel som:
En lærer må kun godkende submissions fra et spil, læreren administrerer.
hører naturligt hjemme i backendens forretningslogik.
En regel som:
En Submission skal referere til en eksisterende Activity.
kan med fordel også håndhæves af databasen.
Jeg ser derfor databasen mindre som et passivt lager og mere som en komponent, der kan hjælpe med at sikre, at systemets data forbliver konsistente.
Det passer direkte til mit læringsmål om at kunne begrunde valgene i datamodellen frem for blot at få EF Core til at generere et databaseschema.
Skal data gemmes eller beregnes?
En af de mest interessante diskussioner i projektet har været omkring point.
Når en aktivitet oprettes, kan den have en bestemt pointværdi. Hvis en deltager gennemfører aktiviteten og bliver godkendt, modtager deltageren pointene.
En mulighed ville være kun at gemme aktivitetens pointværdi og beregne spillerens samlede score, når den skal vises.
Forestil dig eksempelvis:
Activity
Points = 10
og senere:
Submission
Status = Approved
Systemet kunne derefter beregne, at den godkendte submission er 10 point værd.
Problemet opstår, hvis aktivitetens værdi senere ændres, hvilket jeg også berører i mit indlæg om Opstart på backendudvikling i QuestGame:
Hvis aktiviteten efterfølgende ændres fra 10 til 20 point, vil en ny beregning betyde, at tidligere deltagere pludselig får 20 point for noget, de oprindeligt fik 10 point for.
Derfor giver det i vores tilfælde bedre mening at gemme den faktisk tildelte værdi:
public int? PointsAwarded { get; set; }Code language: JavaScript (javascript)Dermed bliver pointene historiske data.
Det betyder også, at PointsAwarded ikke nødvendigvis er overflødige data, selvom værdien i første omgang stammer fra aktiviteten.
Det er et godt eksempel på noget, jeg er blevet mere opmærksom på gennem arbejdet med databaser:
At data kan beregnes betyder ikke nødvendigvis, at de bør beregnes hver gang.
Man må i stedet overveje, hvad dataene repræsenterer.
Aktivitetens Points beskriver, hvad aktiviteten er værd nu.
PointsAwarded beskriver, hvad spilleren faktisk fik på et bestemt tidspunkt.
De to værdier repræsenterer derfor ikke helt det samme.
Denne problemstilling rammer meget præcist mit læringsmål om at kunne træffe og begrunde valg omkring datamodellering.
Forskellige submissions giver forskellige modelleringsbehov
Aktiviteter i QuestGame kan være forskellige.
En quiz kan ofte evalueres automatisk, mens en fysisk aktivitet eller anden opgave kan kræve manuel godkendelse fra en lærer eller game master.
Derfor arbejder vi blandt andet med forskellige typer submissions.
De har noget tilfælles:
Participant
Activity
SubmittedAt
Status
PointsAwarded
men kan samtidig have forskellige oplysninger.
En quizbesvarelse kan eksempelvis have valgte svar, mens en almindelig opgave kan have en anden form for resultat.
Det skaber nogle datamodelleringsdilemmaer:
- Skal alle typer gemmes i én stor tabel?
- Skal de opdeles i flere tabeller?
- Eller skal der være en fælles struktur med specialiserede data ved siden af?
Der findes ikke nødvendigvis ét korrekt svar. Valget afhænger blandt andet af, hvor forskellige typerne bliver, hvilke forespørgsler vi skal udføre, og hvor komplekst systemet skal være.
I vores projekt er pragmatik også vigtig. Vi udvikler systemet inden for et enkelt semester, og derfor skal datamodellen ikke være mere avanceret end nødvendigt.
For mig er læringen derfor ikke nødvendigvis at finde den mest avancerede modellering, men at kunne argumentere for hvorfor en bestemt model er tilstrækkelig til vores use cases.
EF Core som bindeled mellem objekter og relationelle data
Til dataadgangen anvender vi Entity Framework Core.
Det gør det muligt at arbejde med databasen gennem C#:
var game = await dbContext.Games
    .Include(g => g.Activities)
    .FirstAsync(g => g.Id == gameId);Code language: JavaScript (javascript)
EF Core oversætter derefter forespørgslen til SQL, som PostgreSQL kan udføre.
Det er praktisk, men EF Core fjerner ikke behovet for at forstå databasen.
Hvis jeg eksempelvis skriver:
.Include(g => g.Activities)Code language: JavaScript (javascript)bør jeg stadig forstå, at der bagved ligger en relation mellem tabellerne, og at den måde, jeg henter data på, kan påvirke den SQL, der bliver sendt til databasen.
Det er derfor ikke nok for mig at lære EF Core som API.
Jeg vil også forstå, hvad abstraktionen skjuler.
Det gælder blandt andet:
- foreign keys
- joins
- indexes
- constraints
- nullability
- cardinalitet
- genereret SQL
På den måde bliver EF Core et værktøj oven på min databaseforståelse i stedet for en erstatning for den.
Code First betyder ikke, at databasen designer sig selv
Vi bruger en Code First-tilgang.
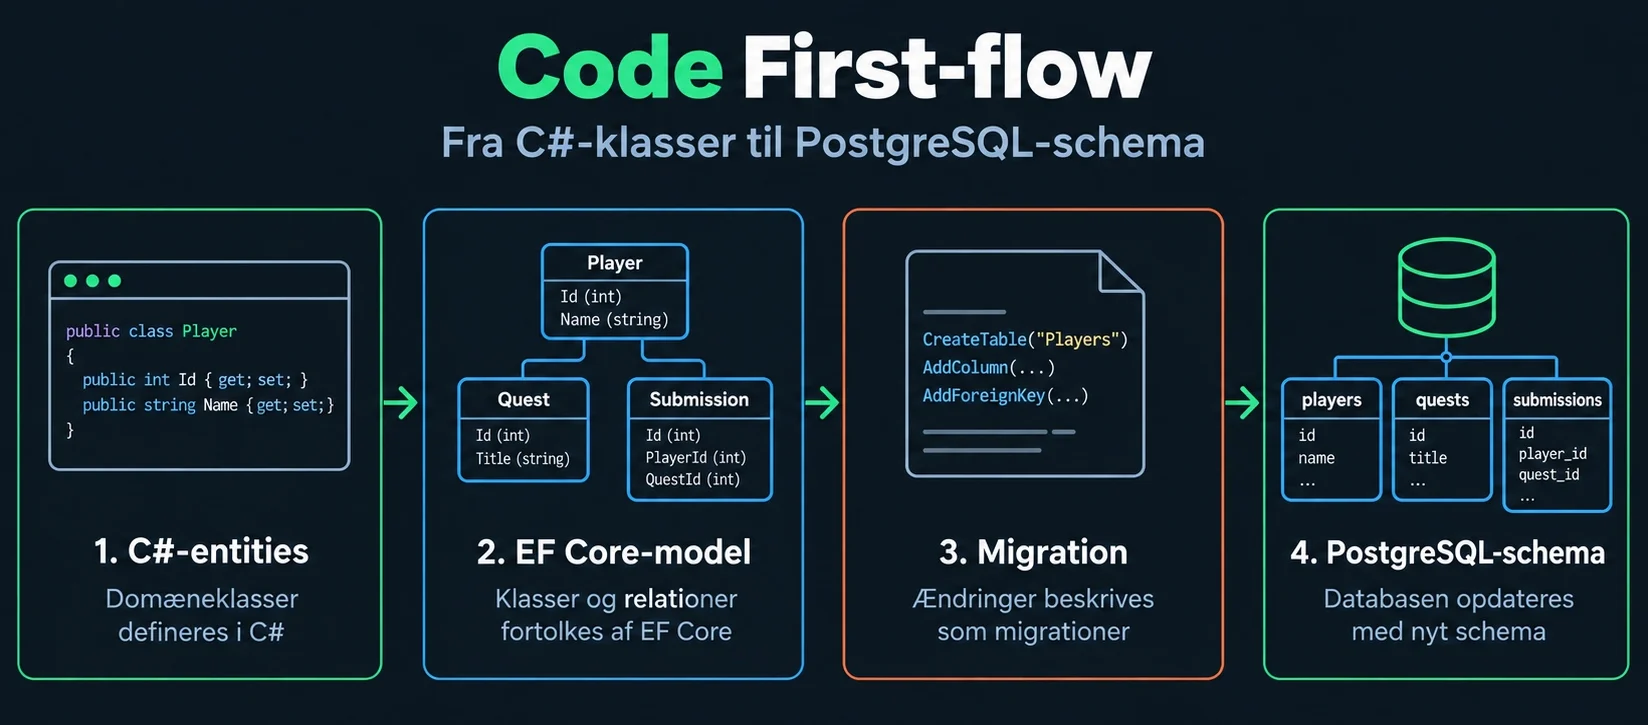
Datamodellen beskrives i C#, hvorefter EF Core kan generere migrations ud fra ændringerne.
Workflowet kan eksempelvis se sådan ud:
dotnet ef migrations add AddSubmissions
dotnet ef database update
Det gør det nemt at udvikle backend og database parallelt.
Men en vigtig erkendelse for mig har været, at betegnelsen Code First nemt kan give det indtryk, at databasen blot følger efter C#-koden.
Sådan bør jeg efter min egen opfattelse ikke arbejde med det.
Selvom modellen defineres gennem C#, bør jeg stadig tænke i den database, modellen bliver omsat til.
Hvis jeg eksempelvis laver:
public string Name { get; set; }Code language: JavaScript (javascript)bør jeg stadig tage stilling til spørgsmål som:
- Hvor lang må værdien være?
- Må den være null?
- Skal den være unik?
- Skal der være et indeks?
Databasedesign forsvinder altså ikke, fordi schemaet genereres fra C#.
Code First ændrer primært måden skemaændringer beskrives og håndteres på.
Migrations som versionshistorik for databasen
Jeg betragtede tidligere migrations mest som noget, der skulle køres for at få databasen til at passe til mine entities.
Arbejdet med projektet har gjort mig mere opmærksom på, at migrations også fungerer som en form for versionshistorik for databaseskemaet.
Hvis vi eksempelvis først opretter Game og Activity og senere introducerer Submission, bliver udviklingen af datamodellen dokumenteret gennem migrations.
Det giver også nogle praktiske fordele i et gruppeprojekt.
Hvis en anden udvikler henter ændringerne, kan vedkommende opdatere sin database til samme schema.
Men migrations betyder samtidig, at schemaændringer bliver noget, jeg skal tage alvorligt.
At omdøbe en kolonne, ændre en datatype eller gøre et felt obligatorisk kan have konsekvenser for eksisterende data.
Derfor forsøger jeg også at læse de migrations, EF Core genererer, i stedet for bare automatisk at køre dem.
Det understøtter mit læringsmål, fordi jeg dermed arbejder med både EF Core-integrationen og selve udviklingen af databaseschemaet.
Lokationsdata er mere end latitude og longitude
Geografiske lokationer er en central del af QuestGame.
Hvert waypoint findes på en bestemt fysisk placering, og spillerens position skal kunne sammenlignes med disse punkter.
En simpel model kunne gemme koordinaterne som to almindelige tal:
Latitude
Longitude
Det ville være muligt, men PostgreSQL ville så i udgangspunktet blot betragte dem som almindelige numeriske værdier.
Med PostGIS kan vi i stedet arbejde med egentlige spatiale datatyper.
På .NET-siden kan en placering blandt andet repræsenteres med Point fra NetTopologySuite:
public Point Location { get; set; } = null!;Code language: JavaScript (javascript)Når det mappes gennem Npgsql og EF Core, kan lokationen gemmes som en spatial datatype i PostgreSQL/PostGIS.
Fordelen er ikke kun, at latitude og longitude bliver samlet i ét objekt.
Databasen får samtidig adgang til geografiske funktioner og spatiale forespørgsler.
Det er årsagen til, at PostGIS er interessant for vores projekt.
Skal afstand beregnes i C# eller PostgreSQL?
Et konkret eksempel er spørgsmålet:
Hvilke waypoints ligger tæt på spilleren?
En mulig løsning kunne være:
- Hent alle waypoints fra databasen.
- Send dem til backend.
- Beregn afstanden til hvert waypoint i C#.
- Fjern dem, der ligger for langt væk.
Det kan sagtens fungere med meget små datasæt.
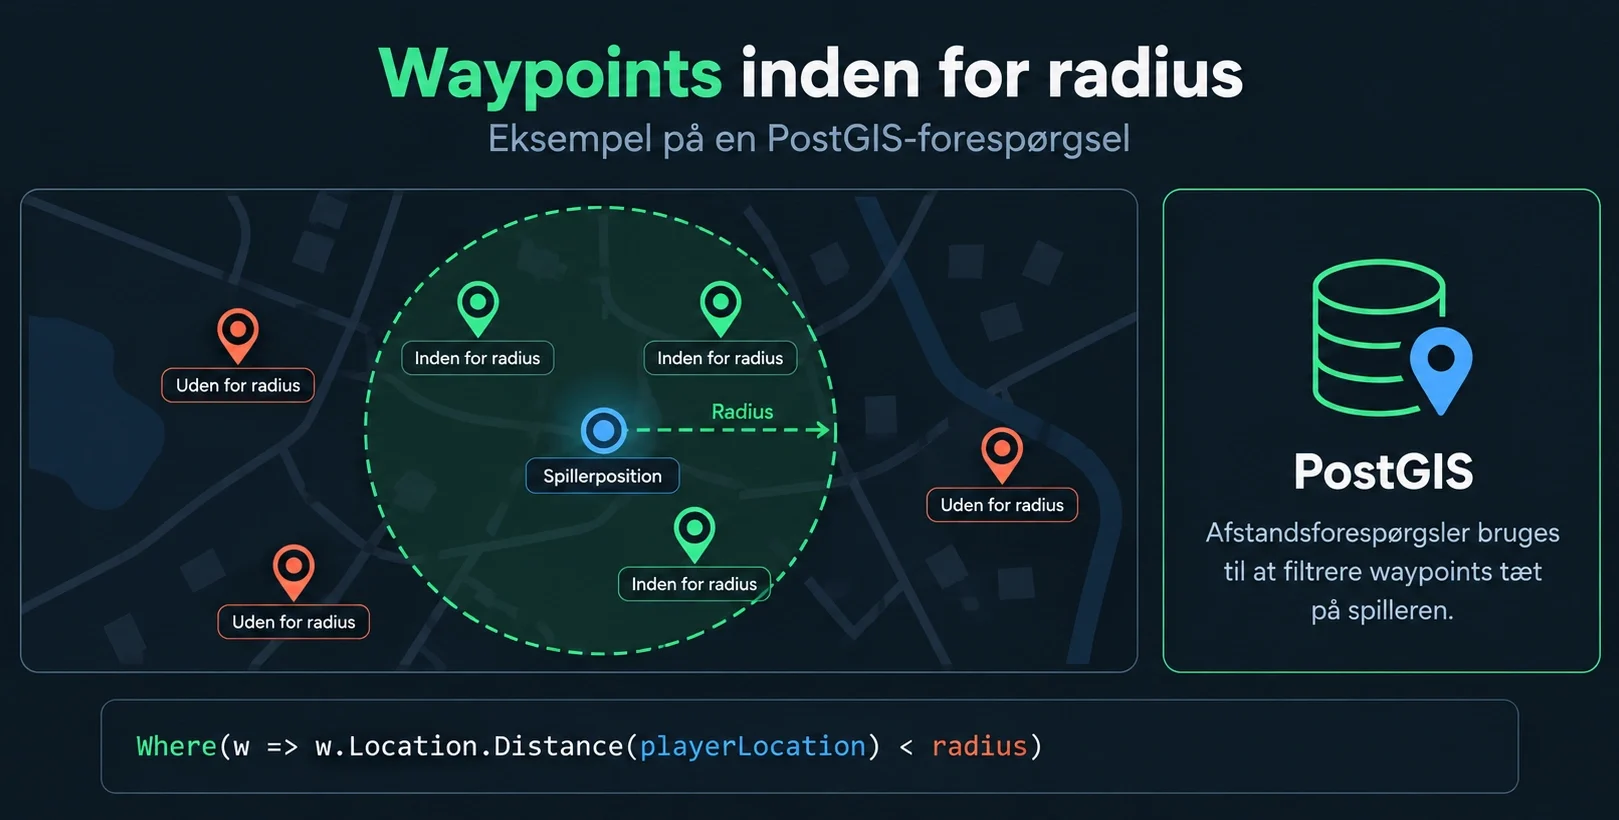
Men databasen har allerede informationerne og kan med PostGIS selv udføre geografiske forespørgsler.
Konceptuelt ønsker vi i stedet noget i retning af:
var waypoints = await dbContext.Waypoints
    .Where(w => w.Location.Distance(playerLocation) < radius)
    .ToListAsync();Code language: JavaScript (javascript)
Så kan operationen, når den kan oversættes af provideren, udføres i PostgreSQL/PostGIS.
Databasen returnerer dermed kun de waypoints, der faktisk er relevante.
Det er et af de bedste konkrete eksempler på mit PostGIS-delmål.
Målet er nemlig ikke bare:
Jeg vil kunne bruge PostGIS.
Det interessante er at kunne vurdere:
Hvornår giver det mening at lade databasen håndtere geografiske operationer frem for backend?
Her mener jeg, at afstandsfiltrering er et godt eksempel på en operation, der naturligt kan placeres tæt på dataene.
Indekser bliver relevante, når forespørgslerne bliver konkrete
En anden ting jeg er begyndt at tænke mere over, er indexes.
Det er nemt at sige, at indexes gør en database hurtigere, men det er ikke et mål i sig selv at oprette flest muligt.
Et indeks giver først mening i relation til de forespørgsler, systemet udfører.
Hvis vi eksempelvis ofte finder en bruger på baggrund af et bestemt felt eller finder submissions for en bestemt aktivitet, kan det være relevant at undersøge, hvordan forespørgslen udføres og om et indeks er hensigtsmæssigt.
Det samme gælder geografiske data, hvor PostGIS understøtter spatiale indeks.
Jeg vil derfor helst undgå at oprette indexes ud fra en forestilling om, at “det felt ser vigtigt ud”.
I stedet vil min proces indledningsvist være:
Use case
   ↓
Forespørgsel
   ↓
Undersøg udførelsen
   ↓
Vurder behov for indeksCode language: JavaScript (javascript)
Det er endnu et eksempel på, at databasedesign efter min opfattelse bør tage udgangspunkt i systemets faktiske brug frem for generelle regler.
Backend og database har hver deres ansvar
Arbejdet med QuestGame har gjort grænsen mellem backend og database mere interessant for mig.
Jeg startede semesteret med en forholdsvis simpel forestilling:
- Backend = logik
- Database = data
Det er stadig en brugbar tommelfingerregel, men virkeligheden er mere nuanceret.
Databasen kan blandt andet håndtere:
- relationer
- constraints
- uniqueness
- indexes
- transaktioner
- geografiske operationer
- filtrering og aggregering
Backend håndterer blandt andet:
- autorisation
- use cases
- forretningsregler
- workflow
- API’et
- koordinering mellem forskellige operationer
Spørgsmålet er derfor ikke, om logikken skal ligge enten i backend eller database.
Spørgsmålet er snarere, hvilken komponent der er bedst egnet til det konkrete ansvar.
Det er netop denne vurdering, jeg gerne vil blive bedre til gennem mit læringsmål.
Status på mit læringsmål
Jeg er stadig i gang med at udvikle både datamodellen og implementeringen, men jeg synes allerede, at mit syn på databaser har ændret sig.
Tidligere har jeg ofte betragtet en database som noget, jeg designede først og derefter brugte fra min applikation.
I QuestGame oplever jeg i højere grad datamodellen som noget, der udvikler sig sammen med systemets use cases.
Når vi ændrer på reglerne for submissions, påvirker det datamodellen.
Når vi diskuterer point, opstår spørgsmålet om historiske data.
Når vi arbejder med waypoints, opstår spørgsmålet om spatiale datatyper og PostGIS.
Og når backend skal hente data, bliver relationer, queries og indexes relevante.
Mit læringsmål handler om at kunne designe og implementere en relationel dataløsning og samtidig kunne træffe og begrunde mine valg.
Indtil videre synes jeg især, at projektet har udviklet min forståelse på fire områder:
- Datamodellering:
Jeg tænker i højere grad over, hvad data repræsenterer, og hvilke relationer der følger af domænet. - Dataintegritet:
Jeg er blevet mere opmærksom på, hvilke regler databasen selv kan hjælpe med at håndhæve. - EF Core og Code First:
Jeg ser i mindre grad EF Core som noget, der skjuler databasen, og mere som et værktøj til at bygge bro mellem objektmodellen og den relationelle model. - PostGIS:
Jeg har fået et konkret område, hvor databasen kan mere end blot traditionel lagring, og hvor placeringen af beregninger mellem backend og database bliver en reel designbeslutning.
Mit næste skridt bliver at fortsætte implementeringen og se, hvordan datamodellen holder, når flere af spillets use cases bliver koblet på.
Jeg forventer ikke, at den model, vi har nu, bliver den endelige.
Tværtimod vil ændringer undervejs være interessante at dokumentere, fordi de kan vise, hvilke antagelser der viste sig at holde, hvilke der ikke gjorde, og hvorfor datamodellen blev ændret.
Det er sandsynligvis netop dér, en stor del af min læring kommer til at ligge.
 Documentationpostgis.net (åbner i en ny fane)Spatial Mapping with NetTopologySuite | Npgsql Documentationnpgsql.org (åbner i en ny fane)
 5.5. Constraintspostgresql.org (åbner i en ny fane)
 Indexes – EF Corelearn.microsoft.com (åbner i en ny fane)Migrations Overview – EF Corelearn.microsoft.com (åbner i en ny fane)Introduction to relationships – EF Corelearn.microsoft.com (åbner i en ny fane)